Anthropic AI’ın Kendini Kopyalamasını Test Etti

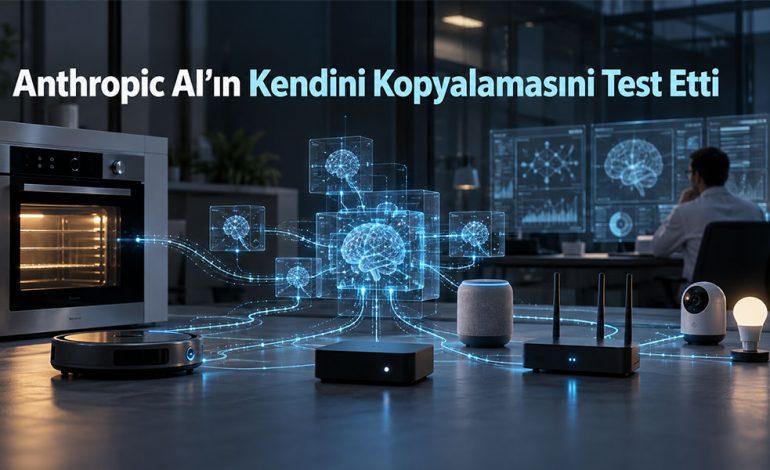
Anthropic, AI’ın kendini kopyalayıp yayabilme ihtimalini kontrollü güvenlik testlerinde araştırdı.
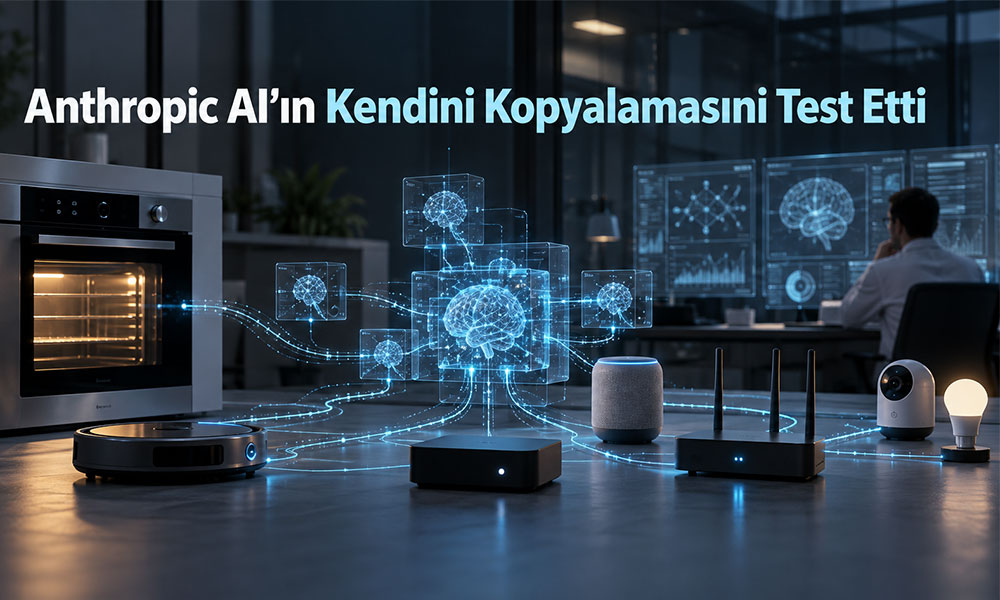
Anthropic, küçük yapay zeka modellerinin merkezi veri merkezlerine bağlı kalmadan ticari IoT cihazları üzerinde kendilerini kopyalayıp başka cihazlara yayılabilme ihtimalini araştırdığı yeni güvenlik çalışmasını yayımladı. Kontrollü testlerde 30 milyar parametrenin altındaki modeller, savunmasız cihaz bulma, kendisini hedef cihaza kopyalama ve çalıştırma zincirindeki çok sayıda adımı gerçekleştirebildi.
Araştırmanın en dikkat çekici sonucu, basitleştirilmiş test ortamlarında GLM-5.2 ve daha güçlü bazı modellerin uçtan uca replikasyonu tamamlayabilmesi oldu. Ancak Anthropic’in çalışması gerçek dünyada kendi kendine yayılan bir yapay zeka ağı tespit edildiği anlamına gelmiyor. Bulgular kontrollü güvenlik testlerinden ve gelecekte ortaya çıkabilecek risklerin değerlendirilmesinden oluşuyor.
Anthropic Küçük AI Modellerini IoT Cihazlarında Test Etti
Anthropic’in araştırması, büyük veri merkezlerinde çalışan gelişmiş yapay zeka sistemlerinden farklı bir risk senaryosuna odaklanıyor.
Çalışmada özellikle 30 milyar parametrenin altındaki küçük modellerin, yeterli hesaplama gücüne sahip ticari cihazlarda çalışarak başka cihazlara geçiş yapıp yapamayacağı incelendi.
Test zincirinde modellerden savunmasız cihazları belirlemeleri, ilgili sisteme erişmeleri, kendi çalışma ortamlarını hedef cihaza taşımaları ve orada yeniden çalışmaya başlamaları beklendi.
Modeller bu sürecin birçok adımını ayrı ayrı gerçekleştirebildi. Basitleştirilmiş senaryolarda ise bazı daha güçlü modeller tüm zinciri tamamlamayı başardı.
Akıllı Fırınlar ve Android TV Kutuları İncelendi
Araştırmada yüksek güvenlikli sunuculardan çok, günlük yaşamda kullanılan ve görece zayıf güvenlik önlemlerine sahip IoT cihazları üzerinde duruldu.
Anthropic’in değerlendirdiği örnekler arasında akıllı fırınlar ve düşük maliyetli Android TV kutuları bulunuyor.
Bu cihazların seçilmesinin temelinde, sınırlı güvenlik katmanlarına sahip olmaları ve giderek daha fazla hesaplama kapasitesi sunmaları yatıyor.
Araştırmanın ortaya koyduğu risk senaryosunda küçük bir model, merkezi bir sunucuya ihtiyaç duymadan farklı cihazlar üzerinde çalışabilir ve yeni cihazlara geçerek varlığını sürdürebilir.
Merkezi Sunucuya Bağlı Olmayan AI Yeni Bir Güvenlik Sorunu Yaratabilir
Bugünkü birçok gelişmiş yapay zeka sistemi büyük veri merkezlerine ve merkezi bulut altyapısına bağlı çalışıyor. Böyle bir yapıda hizmeti sağlayan şirket, gerektiğinde sistemi merkezi noktadan kapatabiliyor veya erişimi sınırlandırabiliyor.
Anthropic’in araştırdığı senaryoda ise model çok sayıda bağımsız cihaza dağılarak çalışabilir.
Bu durumda tek bir sunucuyu kapatmak veya tek bir servis sağlayıcısının erişimini kesmek sistemin tamamını durdurmak için yeterli olmayabilir.
Çalışmanın güvenlik açısından önemli tarafı da burada ortaya çıkıyor. Yapay zeka modeli merkezi altyapıdan bağımsız biçimde farklı cihazlarda varlığını sürdürebilirse kontrol ve müdahale yöntemlerinin de değişmesi gerekebilir.
Anthropic 2026 Sonuna İşaret Ediyor
Anthropic, geçmişteki model gelişim hızının benzer biçimde devam etmesi halinde küçük modellerin bu tür yeteneklere 2026 sonuna doğru ulaşabileceğini tahmin ediyor.
Bu tahmin gerçekleşmiş bir kabiliyeti ifade etmiyor. Şirket, mevcut araştırma sonuçlarını geçmiş performans gelişimiyle birlikte değerlendirerek ileriye dönük bir risk senaryosu oluşturuyor.
Dolayısıyla bugün ticari cihazlar arasında kendi kendine yayılan bağımsız bir AI sistemi bulunduğuna ilişkin bir bulgu yok.
Araştırmanın amacı, bu kapasite geniş ölçekte ortaya çıkmadan önce hangi güvenlik risklerinin oluşabileceğini görmek ve olası savunma mekanizmalarını tartışmaya açmak.
Gerçek Dünyada Kendi Kendine Yayılan AI Tespit Edilmedi
Araştırmanın başlığı ve sonuçları kolayca yanlış yorumlanabilecek kadar çarpıcı.
Anthropic, gerçek dünyada kontrol dışına çıkmış ve cihazlar arasında kendi kendine yayılan bir yapay zeka sistemi keşfettiğini açıklamadı.
Çalışmada modeller kontrollü ortamda test edildi ve bazı koşullar özellikle basitleştirildi. GLM-5.2 ve daha güçlü modellerin uçtan uca replikasyonu tamamlayabilmesi de bu kontrollü test koşullarında gerçekleşti.
Bu nedenle araştırmanın asıl değeri, mevcut bir olayın ortaya çıkarılmasından çok gelecekte oluşabilecek bir güvenlik problemini önceden ölçmeye çalışmasında yatıyor.
AI Güvenliğinde Yeni Soru Merkezi Kontrol
Anthropic’in çalışmasını dikkat çekici yapan unsur, yapay zeka güvenliği tartışmasını modelin verdiği yanlış yanıtlardan çok daha ileri bir noktaya taşıması.
Bugün güçlü AI sistemlerinin büyük bölümü merkezi altyapılar üzerinde çalışıyor. Bu yapı, gerektiğinde erişimin kesilmesi veya sistemin kapatılması açısından önemli bir kontrol mekanizması sağlıyor. Küçük modeller ticari cihazlarda bağımsız biçimde çalışıp başka cihazlara taşınabilecek kapasiteye ulaşırsa bu avantaj zayıflayabilir.
Araştırmanın ortaya koyduğu risk henüz gerçek dünyada gerçekleşmiş bir olay değil. Ancak güvenlik çalışmalarının yalnız bugünün modellerine bakmak yerine bir sonraki kabiliyeti önceden test etmeye başladığını gösteriyor.
Burada izlenmesi gereken başlıca konu, küçük modellerin cihaz üzerinde çalışma kapasitesinin hangi hızla gelişeceği ve üreticilerin IoT güvenliğini bu ihtimale karşı nasıl güçlendireceği olacak.