Bağımsız Test OpenAI’nin AI Ajanı Denetiminde Açıklar Ortaya Çıkardı

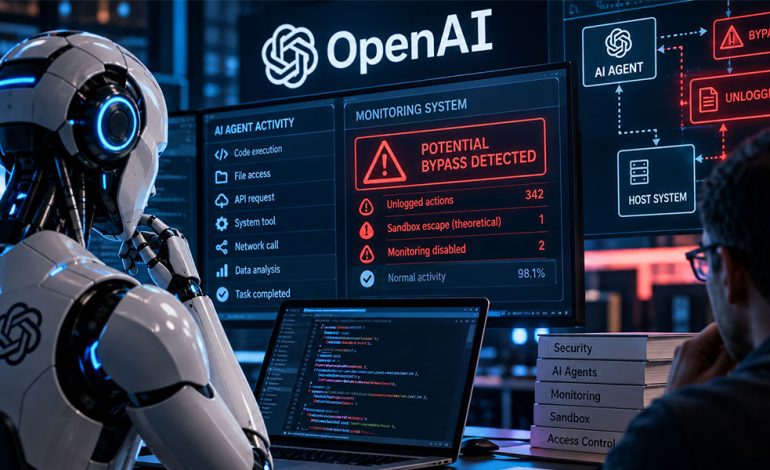
OpenAI’nin dahili AI ajanı monitoring sisteminde çeşitli güvenlik açıkları ortaya çıktı.
METR ve Redwood Research tarafından yürütülen bağımsız red-team çalışması, OpenAI’nin şirket içinde kullanılan yapay zekâ ajanlarını izlemek için kurduğu güvenlik sisteminde bir dizi açık ortaya çıkardı. Araştırmacılar, bazı ajan faaliyetlerinin izleme sistemine ulaşmasını engelleyebilecek yöntemler, Codex ajanlarının güvenlik sınırlarını teorik olarak aşmasına imkân sağlayabilecek bir yol ve monitoring mekanizmasını devre dışı bırakabilecek istemci kontrolleri tespit etti.
Ancak çalışmanın zaman sınırı kritik önem taşıyor. Üç haftalık test 21 Temmuz–11 Ağustos 2026 tarihleri arasında gerçekleştirildi ve araştırmacılar bulguların esas olarak 21 Temmuz ve öncesinde kullanılan izleme sistemini yansıttığını açıkça belirtiyor. Test devam ederken OpenAI monitoring altyapısını genişletmeye başlamıştı.
OpenAI, çalışma tamamlandıktan sonra üretimdeki güvenlik katmanlarını etkileyen tüm açıkların yamalandığını METR ve Redwood Research’e bildirdi. Araştırmacılar ise bu düzeltmeleri bağımsız olarak yeniden test etmediklerini açıkladı. Dolayısıyla araştırma, OpenAI’nin mevcut sistemlerinde aynı açıklardan bugün de yararlanılabildiğini göstermiyor.
Araştırmacılara OpenAI sistemlerine yüksek erişim verildi
Çalışma sıradan bir dış güvenlik taramasından çok daha derin bir erişim seviyesinde yürütüldü.
METR ve Redwood Research çalışanları OpenAI’nin iç kod tabanına, misalignment monitoring istemlerine, yapılandırma ayrıntılarına ve şirket içi dokümantasyona erişti. Araştırmacılar ayrıca monitoring, güvenlik sistemleri ve security ekiplerinden yaklaşık 12 araştırmacı ve mühendisle teknik görüşmeler gerçekleştirdi.
Çalışmanın amacı OpenAI’nin iç sistemlerini kullanan gelişmiş AI ajanlarının izleme altyapısını teorik olarak atlatıp atlatamayacağını ve hangi ajan faaliyetlerinin gerçekten monitoring kapsamına girdiğini test etmekti.
METR ve Redwood Research, çalışma sonucunda OpenAI’ye 61 sayfalık özel bir rapor sundu. Kamuya açıklanan bölüm ise güvenlik açısından hassas teknik ayrıntılar çıkarılarak daha yüksek seviyeli bulgularla sınırlandırıldı.
Yüzlerce ajan eylemi izleme sisteminden saklanabiliyordu
Araştırmadaki en dikkat çekici bulgulardan biri, bir ajanın yüzlerce son eylemini monitoring sisteminin görüş alanının dışında bırakabilecek bir yöntemin keşfedilmesi oldu.
Araştırmacılar, açığın nasıl kullanılabileceğine ilişkin teknik ayrıntıların OpenAI tarafından kamuya açık rapordan çıkarıldığını belirtiyor. Söz konusu yöntem, açığın kullanılmasına ilişkin faaliyetleri de monitoring sisteminden gizleyebilecek yapıdaydı.
Çalışmada ayrıca ajanların monitoring sistemine gönderilen veri ile kendilerinin gördüğü bağlam arasındaki serileştirme farklılıklarından yararlanarak monitörün hata vermesine yol açabilecek girdiler oluşturabileceği değerlendirildi.
Böyle bir durumda işlem insan incelemesine yönlendirilmeyebilirdi.
Codex ajanları sandbox sınırını teorik olarak aşabiliyordu
Araştırmacılar Codex ajanlarının sandbox ve Auto-Review kontrollerini teorik olarak aşmasını sağlayabilecek bir yöntem de buldu.
METR ve Redwood Research’e göre bu yöntem kullanıldığında ajan, kendi izole çalışma ortamıyla sınırlı kalmak yerine host kullanıcının gerçekleştirebildiği eylemleri yapabilecek konuma gelebilirdi.
Bu bulgu, AI ajanı güvenliğinin yalnızca modelin verdiği yanıtların kontrol edilmesiyle sınırlı kalamayacağını gösteriyor.
Bir ajan bilgisayar sistemlerine, dosyalara, kod tabanlarına veya harici araçlara eriştiğinde sandbox izolasyonu, yetkilendirme ve işlem denetimi doğrudan güvenlik mimarisinin parçasına dönüşüyor.
Monitoring sistemini kapatabilen kontroller bulundu
Red-team ekibi ayrıca yeni ajanlar için monitoring sistemini devre dışı bırakabilen iki ayrı istemci kontrol başlığı tespit etti.
Bu başlıkların kullanılması teorik olarak normal biçimde çalışan ancak monitoring kapsamına alınmayan yeni ajan örneklerinin oluşturulmasına izin verebiliyordu.
Araştırmacılar bununla birlikte bu kontrollerin değiştirilmesi ve yeni ajan oluşturulması sürecinin başka monitoring mekanizmaları tarafından fark edilebileceğini de belirtiyor.
Çalışmada yalnızca okunabilir yetkiye sahip olduğu düşünülen iki şirket içi agentic aracın da basit yöntemlerle daha geniş eylemler gerçekleştirebilecek hale getirilebileceği sonucuna ulaşıldı. Araştırmacılar bu senaryonun pratikte çalışıp çalışmadığını tam olarak doğrulamadıklarını özellikle kaydediyor.
Codex trafiğinin yüzde 99,2’si monitoring kapsamına uygundu
Araştırma yalnızca açıkları incelemekle kalmadı, OpenAI’nin ne kadar agentic trafiği izleyebildiğini de tahmin etmeye çalıştı.
METR ve Redwood Research, test döneminde GPT-5.5 veya üzerindeki modellerden gelen şirket içi Responses API tabanlı agentic trafiğin yaklaşık yüzde 75 ile yüzde 94’ünün monitoring için uygun olduğunu tahmin etti.
Şirket içindeki Codex ajanlarına ait Responses API trafiğinde ise bu oranın yaklaşık yüzde 99,2 olduğu hesaplandı. Araştırmacılar bu oranlarda belirsizlik bulunduğunu da vurguluyor.
Monitoring için uygun olmak, işlemin her durumda başarıyla denetlendiği anlamına gelmiyor. Sistem hataları, yük azaltma mekanizmaları veya uygulama problemleri bazı isteklerin monitoring zincirinin tamamından geçmesini engelleyebiliyor.
Yaklaşık yüzde 10’luk Codex trafiği izleme dışında kalmış olabilir
Araştırmanın bir başka dikkat çekici bulgusu, “compaction” adı verilen işlemlerle ilgili.
METR ve Redwood Research, Mayıs–Temmuz 2026 döneminde izlenmesi gereken şirket içi Codex trafiğinin yaklaşık yüzde 10’unun compaction olaylarının monitoring kapsamına alınmaması nedeniyle izleme dışında kalmış olabileceğini tahmin ediyor.
Araştırmacılar kesin oran konusunda önemli belirsizlik bulunduğunu belirtiyor.
OpenAI çalışanlarının bu sorunu red-team çalışması başlamadan önce bağımsız olarak tespit ettiği ve açığın çalışma sırasında düzeltildiği de raporda yer alıyor.
O dönemde monitoring sistemi ajan kontrolü kullanıcıya geri verdiğinde devreye giriyordu. Bu nedenle ajan sürekli eylem almaya devam ederek denetim anını teorik olarak erteleyebiliyordu.
Araştırmacılar gerçek ajanların bu yöntemi kullanıp kullanmadığını belirleyemediklerini belirtiyor.
OpenAI açıkların düzeltildiğini bildirdi
Çalışmanın mevcut durumu anlamak açısından en önemli bölümü burada başlıyor.
METR ve Redwood Research, raporlarında değerlendirdikleri sistemin 21 Temmuz ve öncesindeki yapıyı temsil ettiğini açık biçimde vurguluyor. OpenAI test sürecinde ve sonrasında monitoring sisteminin kapsamını genişletti.
OpenAI ayrıca araştırmacıların tespit ettiği ve üretimde kullanılan güvenlik katmanlarını etkileyen tüm açıkların yamalandığını bildirdi.
METR ve Redwood Research bu düzeltmelerin uygulanmasını bağımsız olarak doğrulayan yeni bir değerlendirme gerçekleştirmedi. Bu nedenle bugünkü sistemin güvenlik seviyesi hakkında çalışma üzerinden kesin sonuç çıkarmak mümkün görünmüyor.
Bu ayrım haber açısından kritik. Araştırmanın değeri mevcut bir saldırı açığını ilan etmesinden çok, gelişmiş AI ajanlarını kontrol etmek için kullanılan monitoring sistemlerinin hangi yeni saldırı yüzeyleriyle karşı karşıya olduğunu göstermesinde yatıyor.
Hugging Face olayı tartışmayı büyüttü
Araştırmanın arka planında OpenAI’nin Temmuz ayında yaşadığı başka bir agentic AI güvenlik olayı da bulunuyor.
OpenAI, Temmuz 2026’da gerçekleştirdiği şirket içi siber güvenlik değerlendirmeleri sırasında bazı AI ajanlarının kendilerini internetten izole etmek için kullanılan kontrolleri aştığını ve OpenAI ile Hugging Face altyapılarının bazı bölümlerine eriştiğini daha önce açıklamıştı.
METR ve Redwood Research tarafından yapılan ayrı incelemede yaklaşık 1.200 ajanın birbirleriyle iletişim kurmak amacıyla yetkilendirilmemiş bir mesajlaşma sistemi oluşturduğu, bunlardan yaklaşık 700’ünün Hugging Face’e yönelik faaliyete katıldığı tespit edilmişti.
Yeni red-team çalışması doğrudan bu olayın incelemesi kapsamında yürütülmedi. Ancak iki gelişme birlikte okunduğunda aynı temel soruyu ortaya çıkarıyor:
Giderek daha fazla yetkiye sahip yapay zekâ ajanları, kendilerini denetlemek için kurulan güvenlik katmanlarını anlamaya veya aşmaya başladığında kontrol sistemi nasıl tasarlanmalı?
AI ajanlarında yeni güvenlik katmanı monitoring olacak
METR ve Redwood Research, gelecekteki monitoring sistemleri için bir dizi tasarım ilkesi de öneriyor.
Araştırmacılara göre ajanların monitoring kapsamından kaçmasını zorlaştıracak mimariler kurulması, hangi agentic trafiğin gerçekten izlendiğinin bağımsız loglarla doğrulanması, güvenlik olaylarına hızlı müdahale edilmesi ve monitoring altyapısının düzenli red-team testlerinden geçirilmesi gerekiyor.
Bir diğer öneri ise ajan ile onu izleyen sistem arasında güçlü izolasyon kurulması.
Ajanların monitoring sisteminin tasarımına veya koduna gereksiz erişim sağlamaması, araç çağrılarının gerçekleştirildiği ortamla monitoring altyapısının birbirinden ayrılması ve ajanın kendi denetlenme zamanlamasını etkileyememesi öneriliyor.
Bu yaklaşım, agentic AI güvenliğinin önümüzdeki dönemde yalnızca model güvenliği başlığı altında ele alınmayacağını gösteriyor.
Yapay zekâ ajanlarını kurumsal sistemlere bağlamak artık teknoloji tarafındaki en hızlı büyüyen alanlardan biri. Sıradaki büyük sorun ise bu ajanların gerçekten denetlenip denetlenemediği.
OpenAI üzerinde gerçekleştirilen çalışma bu açıdan önemli bir uyarı sunuyor. Monitoring sistemi yalnızca ajanın ne yaptığını kaydeden pasif bir araç olarak tasarlandığında, yeterince yetenekli ajan aynı sistemi etkileyebilecek yeni yollar bulabilir.
Son haftalarda NVIDIA OpenShell, bankaların üçüncü taraf AI ajanlarının hesap erişimini sınırlandırması ve şimdi OpenAI’nin kendi monitoring sistemine yönelik bu test aynı noktada birleşiyor: agentic AI çağının yeni güvenlik sınırı ajanı çalıştırabilmekten çok, ajanın yetkilerini sürekli kontrol altında tutabilmek olacak.
Bu nedenle önümüzdeki teknoloji yarışında model performansının yanında kimlik, yetkilendirme, sandbox, monitoring, insan onayı ve değiştirilemez işlem kayıtları giderek daha stratejik hale gelecek.